本文属于 GPT Image 2.5 完整指南 系列。
GPT Image 2.5 中文支持与渲染边界:4 个变量决定汉字出图成败
GPT Image 2.5 的中文能力:官方口径与可用场景
在图像生成模型里,中文字符一直是最难的一类内容 —— 笔画密集、结构复杂、字数一多就容易走形。GPT Image 2.5 在这一项上的官方口径是:能处理包括透明背景在内的更复杂布局,更准确地呈现视觉风格与现实信息,复杂图文混排场景下的中文渲染稳定性提升(来源:OpenAI 官方发布说明)。落到实际场景,就是海报主视觉、产品包装、电商详情页与本地化物料这类「中文和画面长在一起」的需求,第一次有了可以交稿的可能。
但「能力提升」和「每次都准」是两件事。这一页把决定中文出图成败的变量拆开讲清楚,再给你可复制的写法 —— 让你在这个能力区间里尽量少走弯路。
为什么汉字是图像模型最难的一类文字
图像模型不是在「排版」,是在画。传统排版里,字体文件规定了每个字笔画的位置,只要字号够大,字就一定是准的。而生成模型把文字当成画面内容的一部分画出来:它根据训练中学到的字形分布,逐像素预测该出现什么颜色。
这个机制带来三个结论。
一是字越小越难。一个汉字在最终画面里占多少像素,取决于它在画布上的相对大小。标题只占画面高度一小部分时,落在每一笔上的像素非常有限,笔画间隙与起收笔细节更容易被画得含糊。
二是字越多越难。文字总量越大,累积出错的机会越大。这是概率结构:一行 20 个字的出错机会,就是单个字的 20 倍。所以长段落天然比短标题难。
三是字形越复杂越难。繁体字与笔画密集的字,在训练语料里出现得少,模型对它们的字形分布学得也粗。
一句话:中文出图的质量,是「像素预算 × 字数 × 字形复杂度」共同作用的结果。
4 个变量决定汉字出图成败
变量一:字号在画面里的占比。最容易调整、也最见效。把标题放大、让它占据更大的画面高度,等于给每个笔画分配更多像素。判断标准很直接:把图缩到实际投放尺寸后自己都看不清的字,不要指望模型画得更好。
变量二:一次要画多少个字、分几行。大字号短标题一般能一次成型;两三行以内的副文案多数可用,但建议逐字校对;成段正文不要交给模型画,用排版工具叠加。
变量三:字形复杂度。笔画少、结构简单的常用字最稳;笔画密集的字、繁体字、生僻字单独挑出来检查。真正难的是密集字形,不是「中文」这个整体。
变量四:文字在指令里怎么给。最容易被忽略、提升最直接。不要把文字藏在描述性句子里。与其写「做一张有促销气氛的中文海报」,不如把字符串单独列出来、用引号包住,并交代位置与层级。
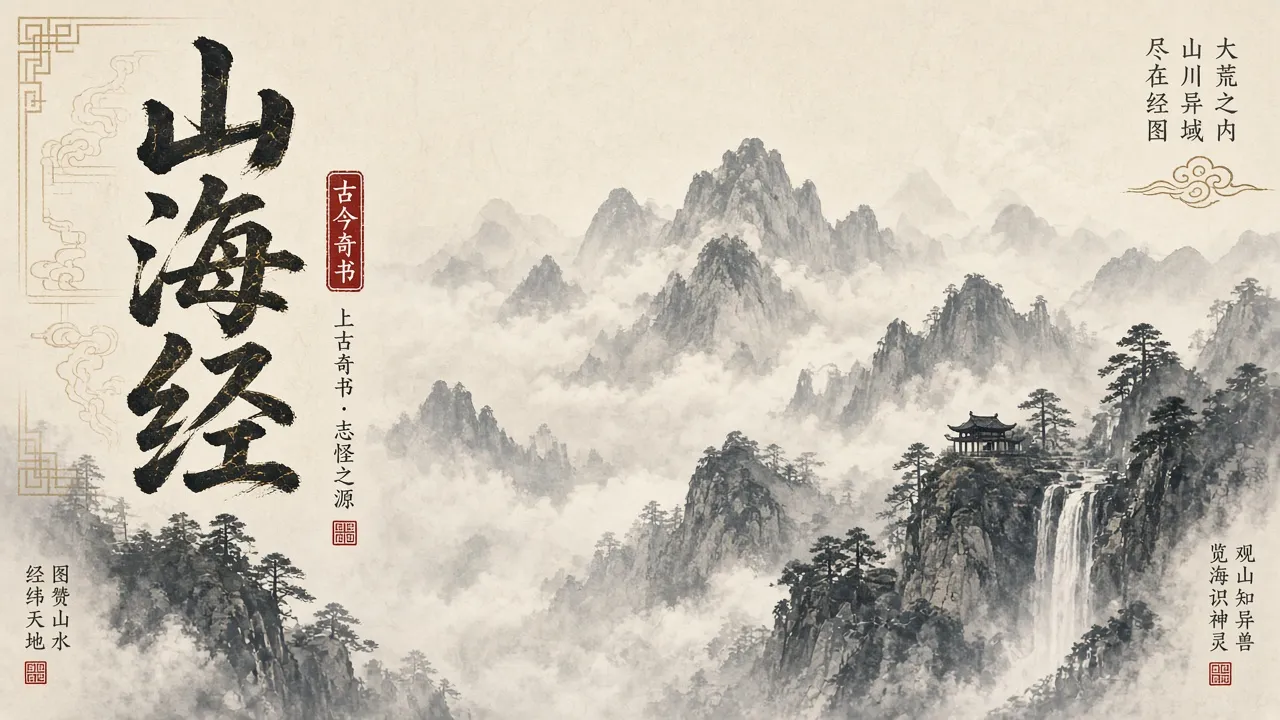
提示词模板:中文海报的句式写法
把变量四落到可复制的句式,中文文字类需求可以按这个结构写。
① 先定画面,再定文字。画面部分照常描述风格、构图、光线,不必提文字。
② 文字单独成段,用引号包住要出现的每一个字符串。例如:画面文字:顶部主标题「限时特惠」;下方一行副标题「活动截止 12 月 31 日」;右下角小字「扫码参与」。
③ 交代位置与层级关系。谁大谁小、谁在上面,直接写出来 —— 模型对「层级」的理解比「美感」可靠得多。
④ 字数做减法。能删的字就删。每删一个字,出错的机会就少一次。
需要更多可复制的句式,见GPT Image 2.5 提示词库;从零到出图的完整步骤见GPT Image 2.5 怎么用。
生成之后:把文字安全区当成硬约束
一是预留安全区。不要把文字顶到画布边缘 —— 同一张图往往要裁成多个尺寸投放,边缘被切掉的字没有补救机会。
二是终稿单独校对文字。校对对象是文字内容本身,不是画面好不好看。逐字读一遍,比看整体观感有效。
三是能把文字和画面分开,就分开。物料允许后期调整时,优先让模型出画面主体,文字用排版工具叠加 —— 这样文字不会因为重新生成而改变。
四是取舍有先后。画布有限、文字又多时:先保字号,再减字数,最后才考虑换字体风格。字号不足带来的含糊,换字体补救不了。
关于中文准确率的一个说明
中文渲染是逐次生成的结果:同一段提示词连跑几次,出错的字可能落在不同位置,所以它不存在一个「永久准确率」。你能拿到的,是自己工作流里反复验证过的安全区间 —— 拿真实要用的提示词在同一个账户里跑三五次,记录哪几个字出错、错在什么位置,就够看出方向。另外,中文字多的海报往往是同一提示词反复重跑才定稿,成本会高于单次生成,计费方式的拆解见GPT-Image-2.5 API 计费详解。
需要横向对照不同模型的公开参数与费率,能比的部分见参数与费率对照。
常见问题
GPT Image 2.5 支持中文吗?
支持,中文字符可以与画面内容一并生成,复杂图文混排是这一代官方强调的改进方向。不过字号、字数与字形复杂度仍会直接影响结果。
为什么小字更容易出错?
因为字号越小,每个笔画在最终画面里占用的像素越少,笔画间隙与起收笔细节更容易被画得含糊。这不是模型不认识这个字,而是像素信息不足。
在提示词里写「请确保文字准确」有用吗?
这类祈使句作用有限。更有效的做法是把要出现的字符串单独用引号列出,并交代位置与层级,同时把字号做大、把字数减少。
繁体字和生僻字能生成吗?
可以生成,但字形越复杂、在训练语料里出现得越少,越容易走形。建议把这类字单独拿出来做终稿校对。
一张海报上最多能放多少中文字?
没有官方硬性上限,但建议只保留必要信息:一个大字号主标题,加一两行副文案。文字越多,出现错字的概率越高 —— 这是逐像素绘制的机制决定的。
本站可以免费用吗?
不能。本站不提供免费积分,也没有免费试用额度,使用站内生成器需要先开通套餐或购买积分包。需要说明的是,OpenAI 官方对 ChatGPT、ChatGPT Work、Codex 全档用户(含免费版)开放了 GPT Image 2.5,那是 OpenAI 的产品政策,与本站在哪里用、怎么收费是两件事。
中文渲染是 GPT Image 2.5 这一代最值得关注的能力之一:它让海报、包装与本地化物料第一次可以「中文和画面一起生成」。把排版条件控制好,这个能力就能稳定地用在真实交付里。更细的其它硬边界(参考图数量、分辨率上限、水印与费率结构)见GPT Image 2.5 局限清单。
相关内容
本站为独立第三方站点,与 OpenAI 无隶属关系。